基礎設施
Home Lab 自架家庭實驗室
自設家庭實驗室 — 三層 VLAN 網絡架構,整合生產、開發、AI 推理、備份多種用途於一體。
使用的技術
Proxmox VEiKuai RouterVLANNASNginxOpenClawDockerCloudflareOracle CloudAliCloudAMD EPYCRTX 5090 ×2UnslothLM Studio
網絡架構
網絡接入:Internet → 光貓 (ONT) → iKuai 路由器(主網關)→ 兩台 Mercury 交換機(6口 + 9口)→ 各設備。 外網服務透過 VPN/Tunnel 連接 AliCloud、Oracle Cloud 及 Cloudflare。
VLAN 分布
| VLAN | 設備 | 主要用途 |
|---|---|---|
| VLAN 1 | PC 1 | 排程、AI 影片處理 |
| VLAN 1 | GPU Server | 本地 LLM 推理(雙 RTX 5090) |
| VLAN 1 | PC 2 | 開發任務(Cursor, Claude Code, Docker) |
| VLAN 1 | mini PC 1 | PVE 生產環境、網頁服務、OpenClaw、Nginx |
| VLAN 1 | Laptops | 日常辦公與個人使用 |
| VLAN 1 | NAS | 數據備份 |
| VLAN 2 | mini PC 2 | PVE Client 遠程控制 VM |
| VLAN 3 | PC 3 | 教學開發 |
AI 推理伺服器 — 雙 RTX 5090
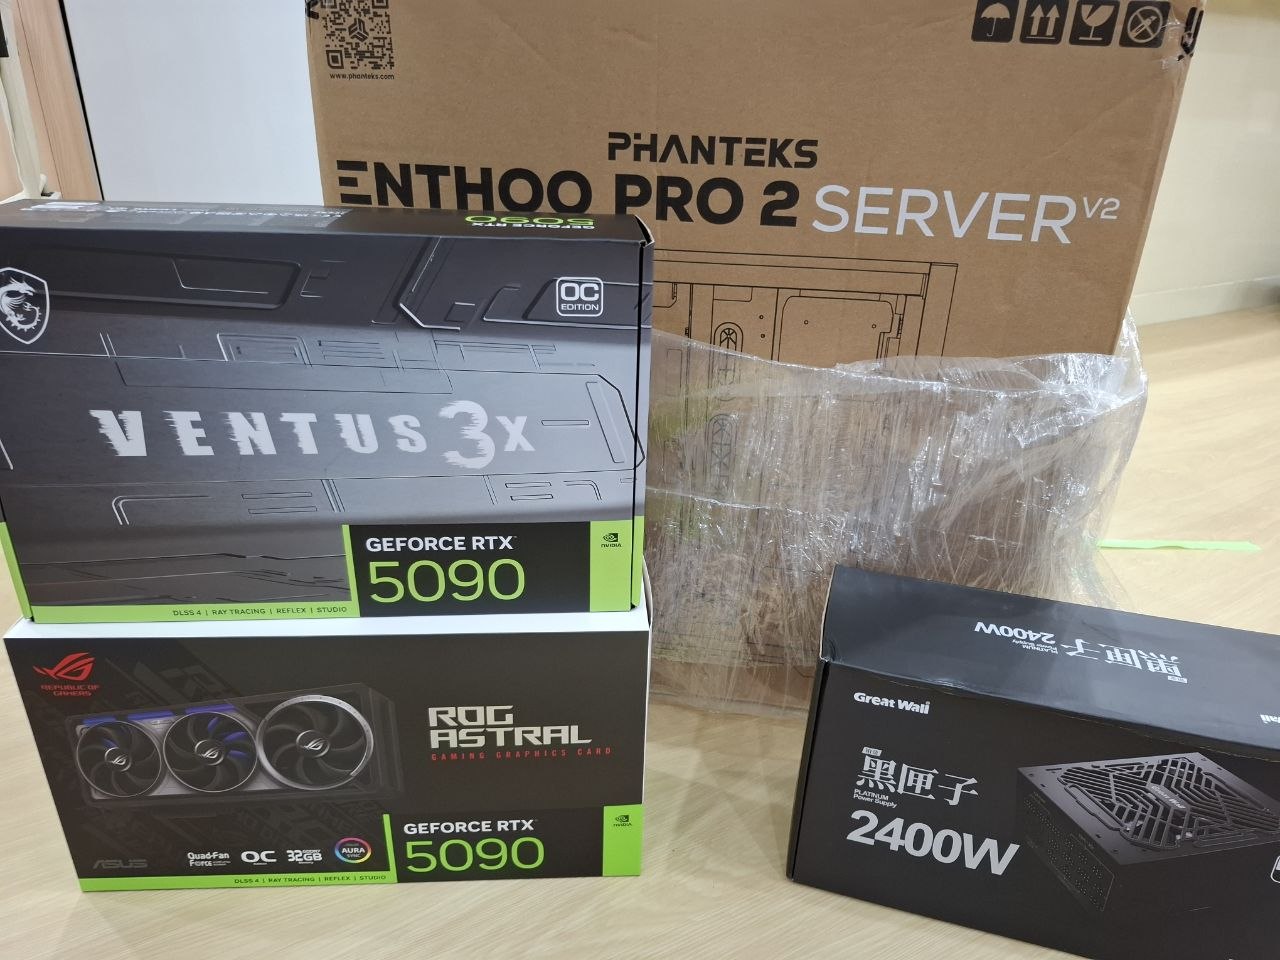
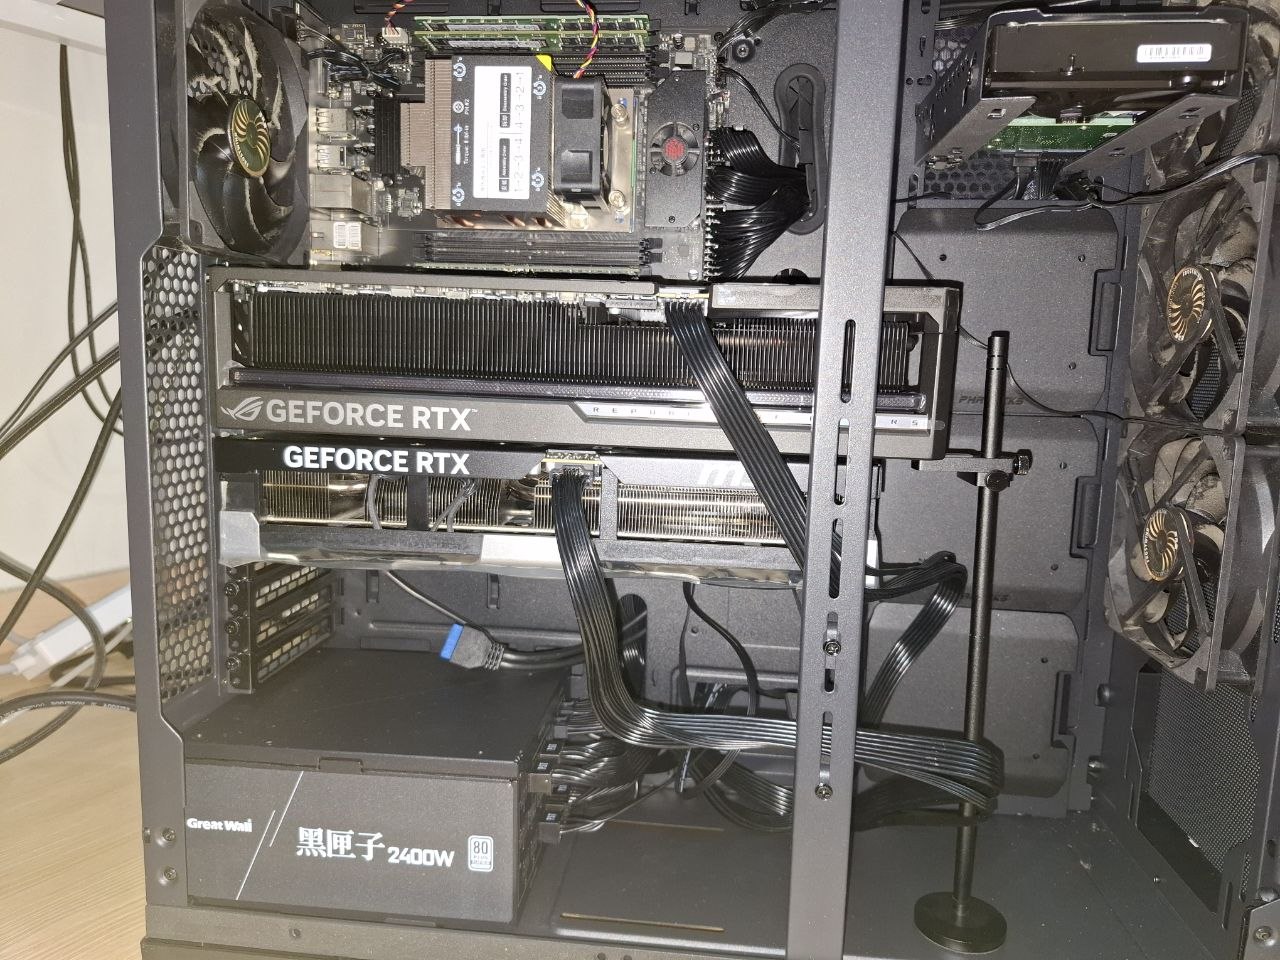
自組的本地 LLM 推理主機,核心為雙 RTX 5090(合共 64GB VRAM),日常運行 Qwen3 系列模型,承擔翻譯、問答、文件處理與開發輔助等推理任務。
| 項目 | 規格 |
|---|---|
| CPU | AMD EPYC 7K62(Rome,16C/32T,128 條 PCIe 4.0 Lane) |
| 主機板 | 華南金牌 Huananzhi H12D-8D Ver2.0(SP3,8 通道 DDR4,內建 BMC/IPMI) |
| 記憶體 | 三星 DDR4-3200 RDIMM 64GB × 4 = 256GB |
| 顯示卡 | ASUS ROG Astral RTX 5090 OC 32GB:357.6 × 149.3 × 76 mm(4-slot 巨卡) MSI Ventus 3X RTX 5090 OC 32GB:325 × 139 × 67 mm(約 3.5 slot) |
| 電源供應 | Great Wall 黑匣子 2400W |
| 機殼 | Phanteks Enthoo Pro 2 Server Edition v2 |
| 作業系統 | Ubuntu(GNOME),NVIDIA Driver 595.84 / CUDA 13.2 |
推理環境:Linux 端以 Unsloth 引擎作雙卡 tensor 並行(RTX 5090 無 NVLink,經 PCIe 4.0 x16 分工),Windows 端以 LM Studio 作對照測試。主力模型為 Qwen3-Next-80B-A3B:Q4 量化 + KV cache Q4,26k 上下文剛好佔滿 64GB VRAM,開啟 MTP(Multi-Token Prediction)後雙卡生成速度約 100 tok/s;較小的 Qwen3-32B(Q4 約 20GB)單卡即可運行。
實機運行數據(nvidia-smi)
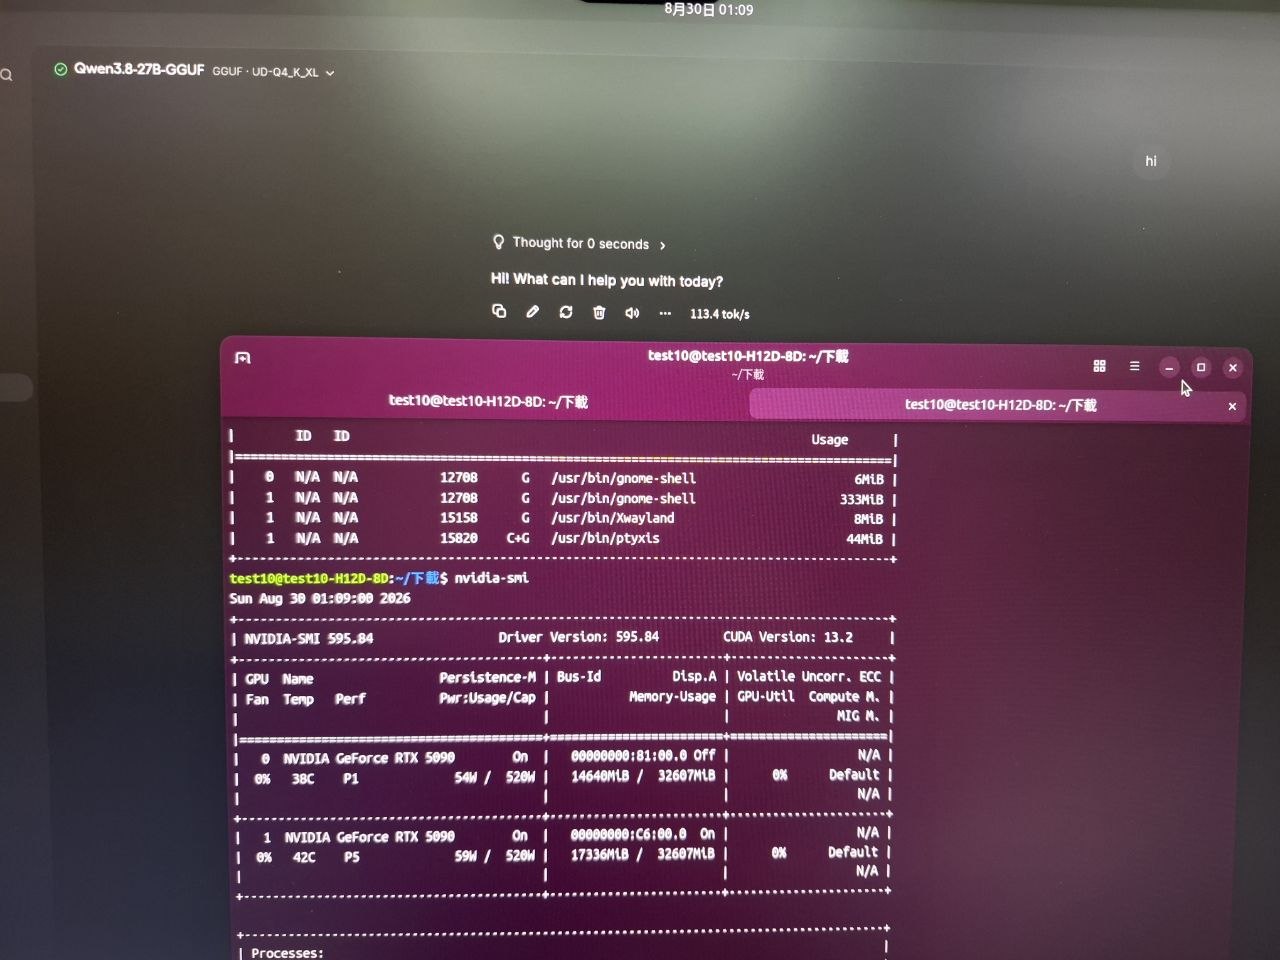
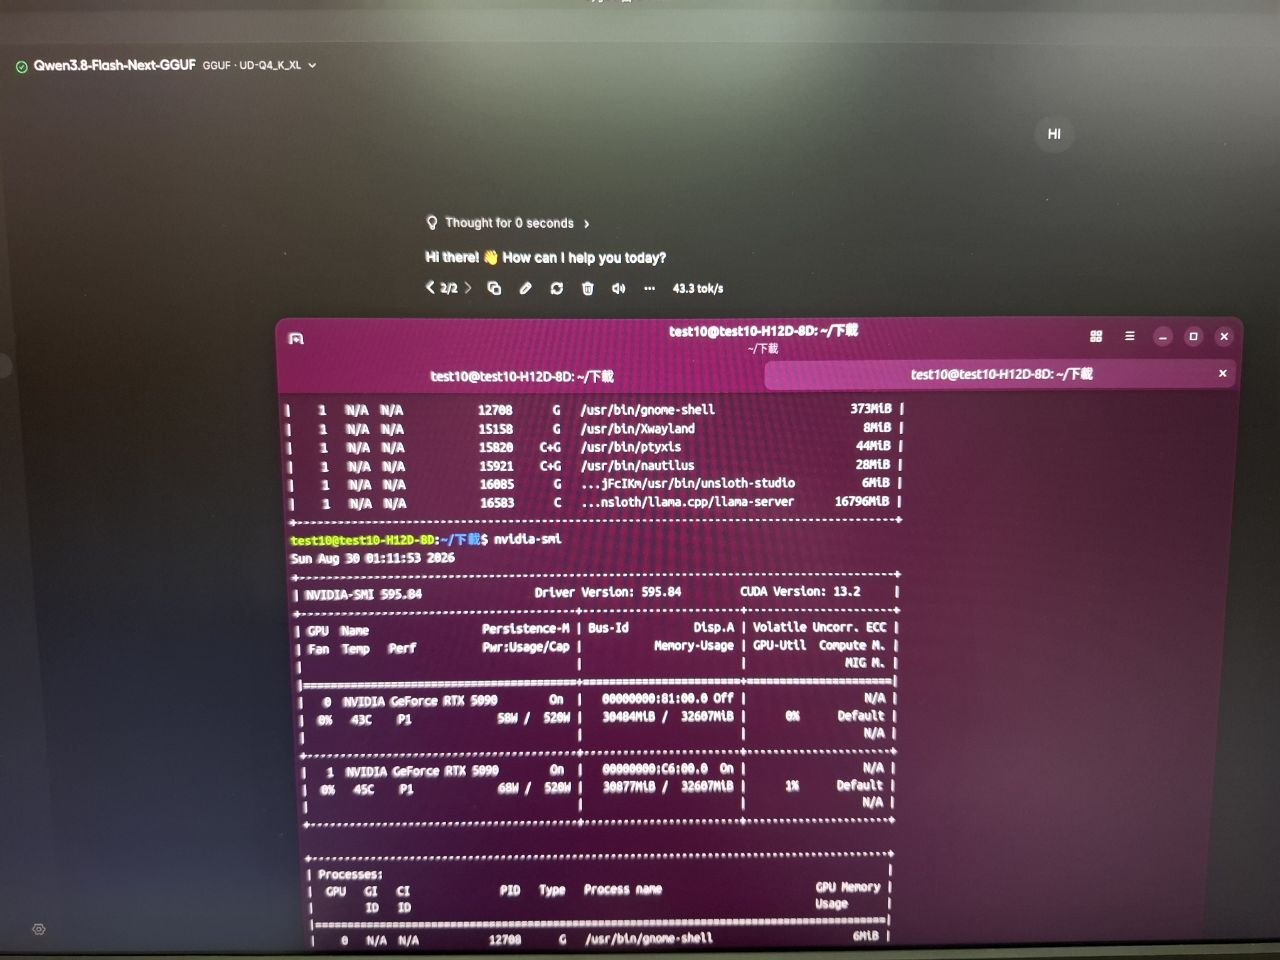
以下為 2026-08-30 實測數據:模型載入前後各讀取一次,閒置時雙卡風扇維持 0% 轉速(零轉速模式)。
| 項目 | GPU 0 | GPU 1 |
|---|---|---|
| 溫度(模型載入前) | 38°C | 42°C |
| 溫度(模型載入後) | 43°C | 45°C |
| 功耗(模型載入前) | 54W / 520W | 59W / 520W |
| 功耗(模型載入後) | 58W / 520W | 68W / 520W |
| VRAM 佔用(載入後) | 30,484 / 32,607 MiB | 30,877 / 32,607 MiB |
雙卡合共佔用約 61.4GB / 64GB VRAM(94%),與 Qwen3-Next-80B Q4 權重 + 26k 上下文 KV cache Q4 的預算吻合;GPU 1 同時負責桌面輸出(gnome-shell,6MiB)。驅動 595.84 / CUDA 13.2。
架構圖

實際設備
